
Wie funktionieren Large Language Models?
Large Language Models, kurz LLMs, erzeugen Texte auf Grundlage statistischer Zusammenhänge. Vereinfacht gesagt analysieren sie den vorhandenen Kontext und bestimmen, welche Fortsetzung wahrscheinlich sinnvoll ist. Das Prinzip erinnert an eine stark weiterentwickelte Form der Wort- beziehungsweise Satzvorhersage.
Durch ihre hohe Komplexität können moderne Modelle wesentlich mehr als einfache Textvervollständigung. Sie können Inhalte zusammenfassen, Texte strukturieren, Fragen beantworten oder bei technischen Aufgaben unterstützen.
Wichtig ist dabei: Eine sprachlich überzeugende Antwort ist nicht automatisch fachlich korrekt. Gerade wenn entscheidende Informationen fehlen, kann ein Modell eine plausible Antwort erzeugen, die nicht zum tatsächlichen Anwendungsfall passt.
Guter Kontext verbessert die Ergebnisse
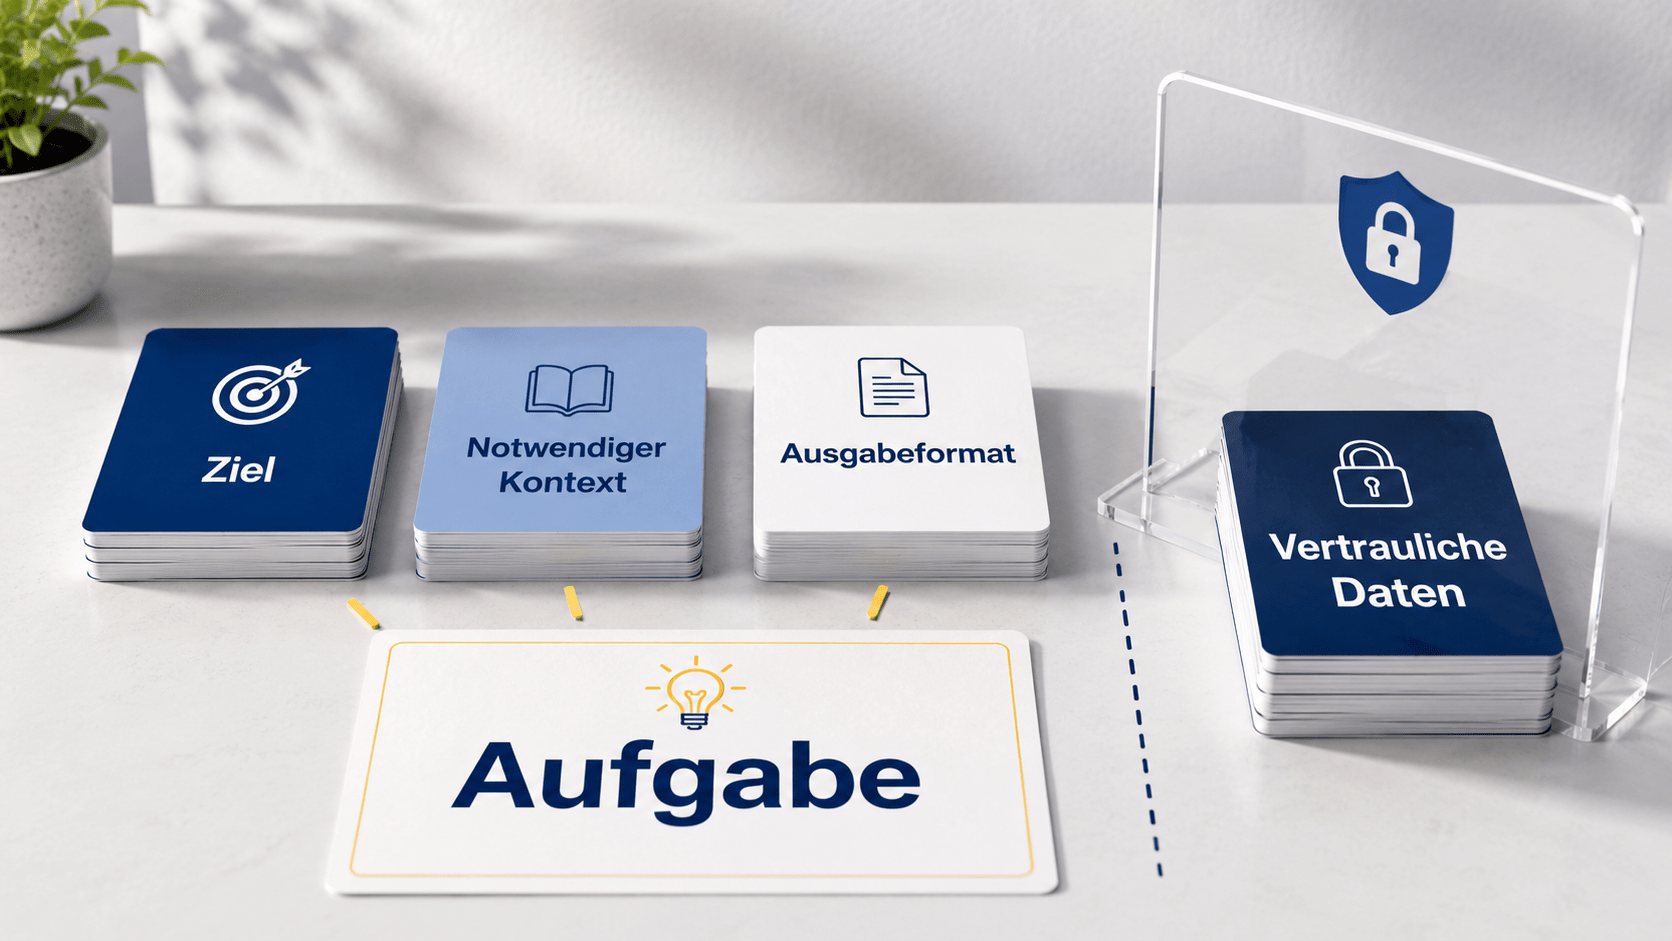
Je besser ein LLM die Aufgabe versteht, desto gezielter kann es antworten. Ein Prompt wie „Wie kann KI in einem Unternehmen eingesetzt werden?“ lässt sehr viele Interpretationen zu.
Hilfreicher ist es, zusätzlich relevante Rahmenbedingungen zu nennen:
- Was genau ist das Ziel?
- Für wen ist die Antwort bestimmt?
- In welchem fachlichen Kontext wird gearbeitet?
- Welches Ergebnis wird erwartet?
- In welchem Format soll die Antwort zurückgegeben werden?
- Welche technischen oder organisatorischen Rahmenbedingungen gelten?
Auch größere Aufgaben lassen sich häufig besser in mehrere klar definierte Schritte aufteilen. Präzise Anforderungen und ein eindeutiges Ausgabeformat reduzieren Interpretationsspielraum.
Dabei entsteht allerdings ein Spannungsfeld: Mehr Kontext kann die Qualität verbessern – gleichzeitig kann zusätzlicher Kontext sensible Informationen enthalten.
Welche Informationen sollten besonders geschützt werden?
Im Arbeitsalltag ist es verlockend, bei einer schwierigen Aufgabe einfach zusätzlichen Code, Dokumentationen oder technische Informationen in einen KI-Dienst zu kopieren. Genau hier ist besondere Aufmerksamkeit notwendig.
Zu den schützenswerten Informationen zählen insbesondere:
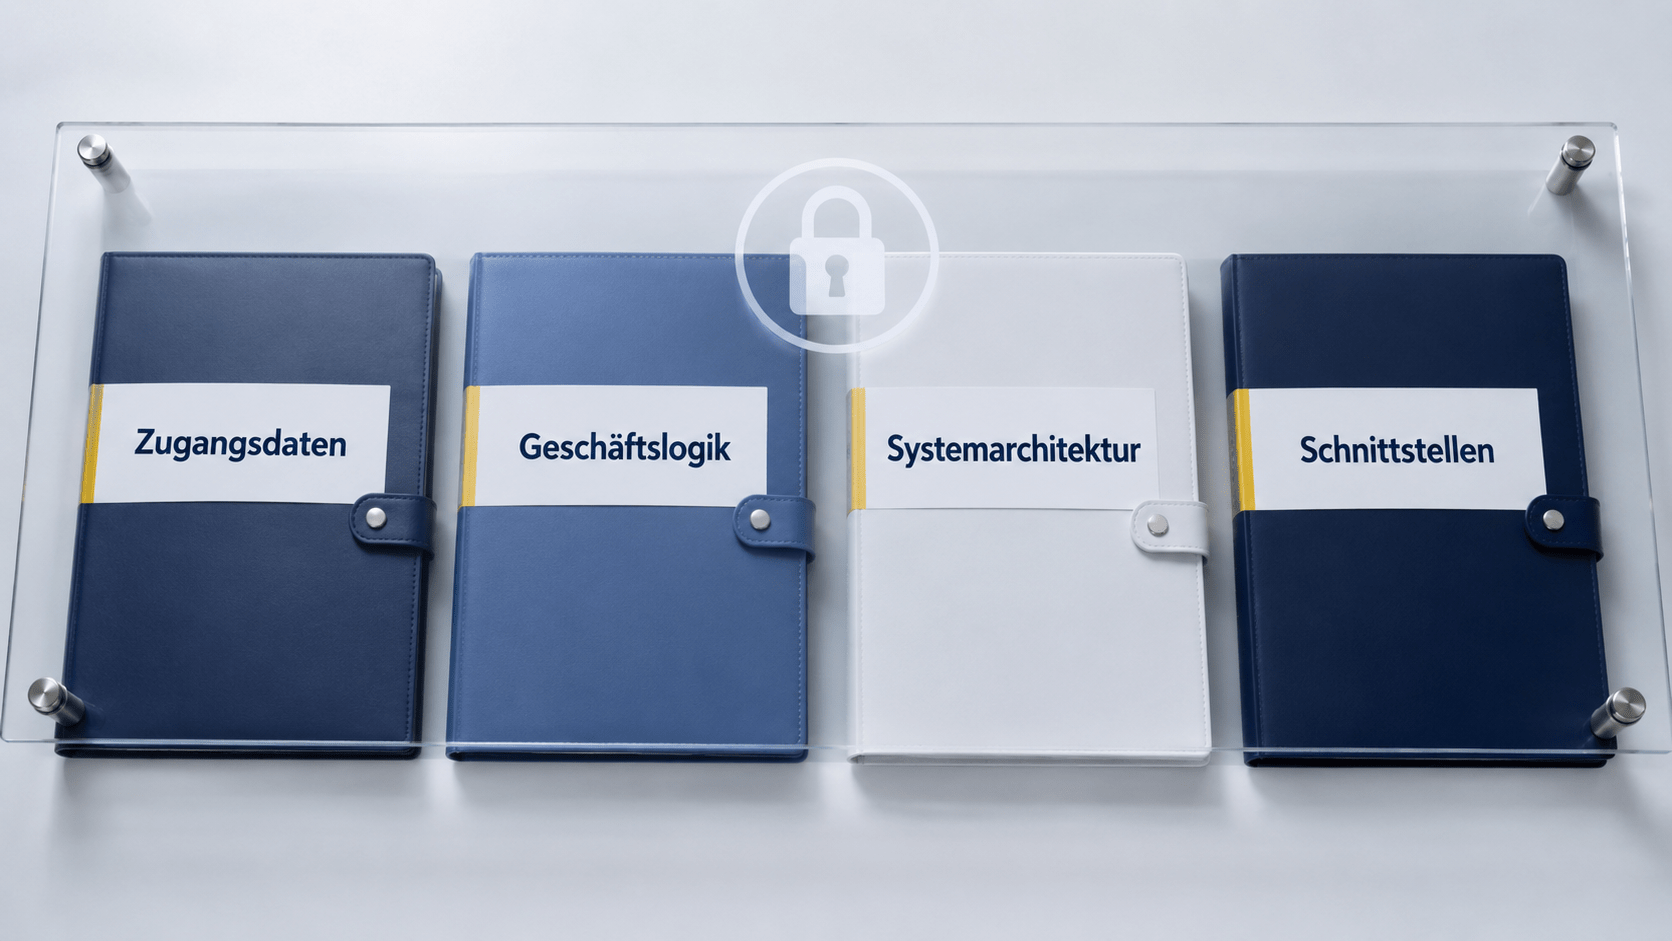
- Passwörter, Schlüssel und andere Zugangsdaten,
- vertrauliche Geschäftslogik,
- interne System- und Netzwerkarchitekturen,
- Routing- und Konfigurationsinformationen,
- API-Verbindungen und Schnittstellendetails,
- Architekturskizzen,
- personenbezogene oder anderweitig sensible Daten.
Solche Informationen können einzeln bereits kritisch sein. Noch problematischer kann eine Kombination verschiedener Daten werden, weil daraus größere Teile einer internen Systemlandschaft oder eines Geschäftsprozesses nachvollziehbar werden können.
Eine praktische Faustregel lautet deshalb: Informationen, die man nicht ungeprüft an eine externe Fachperson weitergeben würde, sollten auch nicht ungeprüft in einen externen KI-Dienst eingegeben werden.
Drittanbieter bewusst auswählen
Nicht nur der eigentliche KI-Anbieter ist relevant. KI-Funktionen können auch über Erweiterungen, Entwicklerwerkzeuge oder andere Dienste eingebunden werden.
Solche Integrationen sind besonders komfortabel, weil sie automatisch auf Dateien oder Projektkontext zugreifen können. Genau deshalb muss jedoch bekannt sein, welche Informationen übertragen werden, wohin sie übertragen werden und wie der Dienst mit ihnen umgeht.
Je nach Dienst und Vereinbarung können sich Datenverarbeitung und Schutzmechanismen unterscheiden. Vor einem Einsatz im Unternehmenskontext sollten deshalb Freigaben, Vertragsbedingungen und Datenschutzvorgaben geklärt werden. Dabei können sowohl eine direkte als auch eine indirekte Weitergabe von Prompt- und Kontextdaten ein relevantes Risiko darstellen.
Vier Strategien für einen sichereren Einsatz
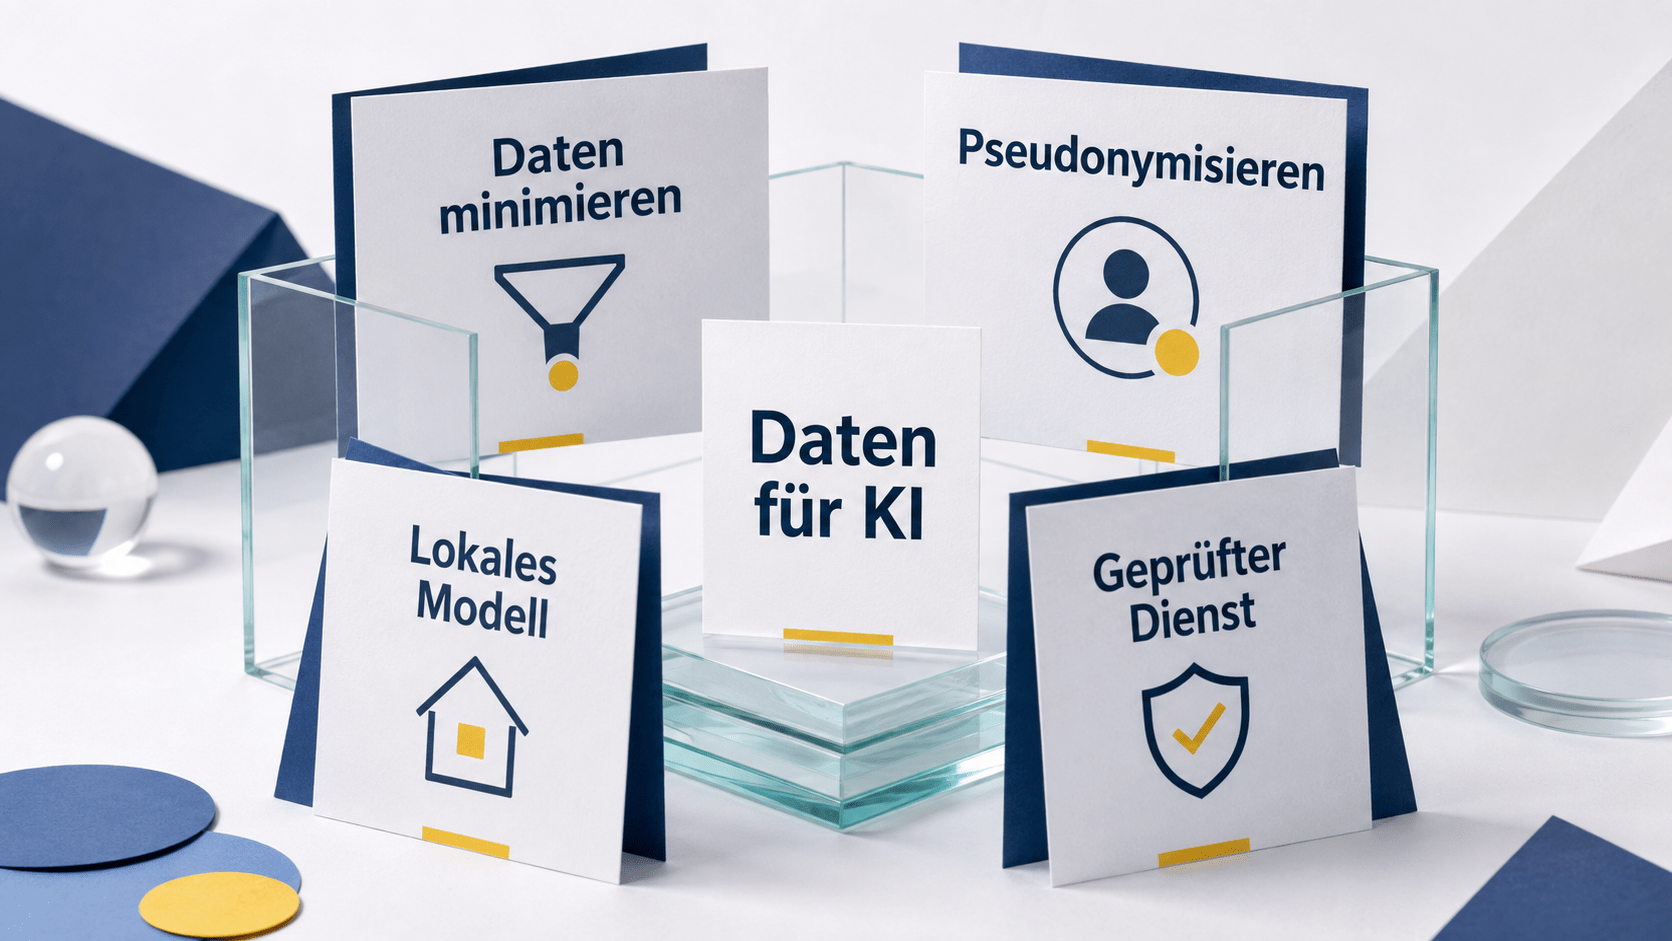
Ein sicherer Umgang mit LLMs muss ihre Nutzung nicht grundsätzlich verhindern. Vielmehr sollte kontrolliert werden, welche Informationen das Modell tatsächlich benötigt.
Datenminimierung ist dabei der einfachste Ansatz: Statt ein vollständiges Projekt oder Dokument bereitzustellen, wird nur der für die konkrete Aufgabe erforderliche Ausschnitt übermittelt.
Bei der Pseudonymisierung werden identifizierende Informationen entfernt oder ersetzt, bevor Inhalte weitergegeben werden.
Für besonders sensible Einsatzbereiche können lokal betriebene Modelle eine Möglichkeit darstellen. Die Daten bleiben dann innerhalb der eigenen Infrastruktur. Dafür entstehen allerdings zusätzlicher technischer Aufwand und entsprechende Infrastrukturkosten.
Eine weitere Möglichkeit sind gezielt ausgewählte externe Dienste, bei denen Datenverarbeitung, Schutzmaßnahmen und vertragliche Rahmenbedingungen transparent geregelt sind.
Fazit
Large Language Models können Arbeitsabläufe erheblich unterstützen – vorausgesetzt, sie erhalten eine klar formulierte Aufgabe und den richtigen Kontext. Gleichzeitig bedeutet guter Kontext nicht, möglichst viele Daten ungefiltert weiterzugeben.
Der entscheidende Grundsatz lautet daher: So viel Kontext wie nötig, so wenig sensible Daten wie möglich.
Datenminimierung, Pseudonymisierung, geeignete Betriebsmodelle und eine bewusste Auswahl externer Dienste helfen dabei, Nutzen und Datensicherheit miteinander zu verbinden. Gleichzeitig bleibt es wichtig, die ausgegebenen Ergebnisse fachlich zu prüfen und den Umgang mit KI innerhalb einer Organisation klar zu regeln.
Wir bei Aschauer IT & Business GmbH betrachten den Einsatz von KI deshalb nicht isoliert von Datenschutz, Informationssicherheit und bestehender IT-Architektur. Ziel ist es, die Möglichkeiten moderner KI sinnvoll zu nutzen, ohne dabei die Kontrolle über vertrauliche Informationen zu verlieren.
Wenn ihr Fragen habt oder mehr über konkrete Einsatzmöglichkeiten erfahren möchtet, nutzt bitte den unten angelegten Kontaktbereich. Wir unterstützen euch gerne bei eurem Vorhaben.
